
O bug mais caro não é o que derruba o sistema. É o que ninguém percebe.
🎧 Ouça este conteúdo
Debate/áudio sobre o erro silencioso vs erro de infraestrutura (6 min). Toque para ouvir:
Leitura: ~6 minutos
TL;DR
- Sistema que cai é barato: todo mundo corre. O erro silencioso segue emitindo nota, baixando estoque e processando pedido errado por semanas.
- Corrigir o bug é rápido; caro é o dado errado acumulado e a decisão tomada em cima dele.
- Log técnico não basta: captura falha de execução, não cálculo errado que executa bem.
- Complemento: observabilidade de negócio (notas, cancelamentos, divergências) + auditoria de dados contra fontes independentes.
←Carrossel da análise — 11 slides→


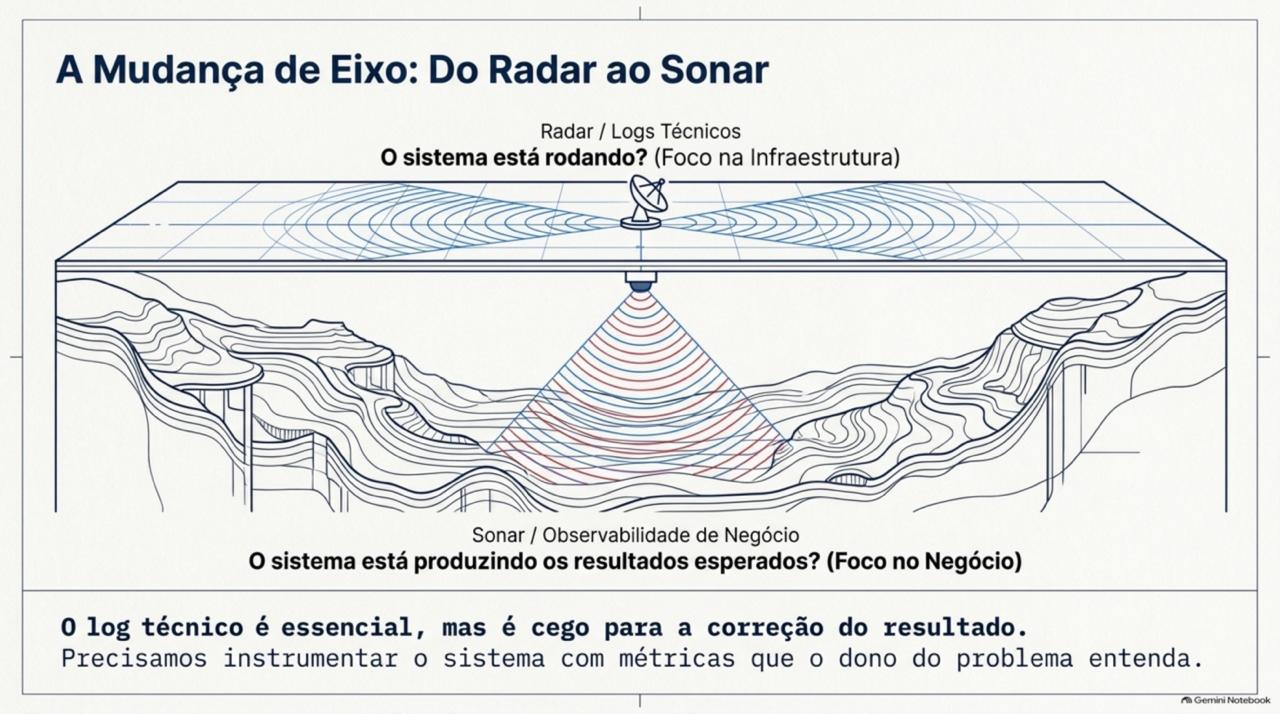

O pior bug que já encontrei não derrubava servidor, não mostrava erro e não aparecia no log. O sistema funcionava perfeitamente. Esse era justamente o problema.
O erro visível é o barato
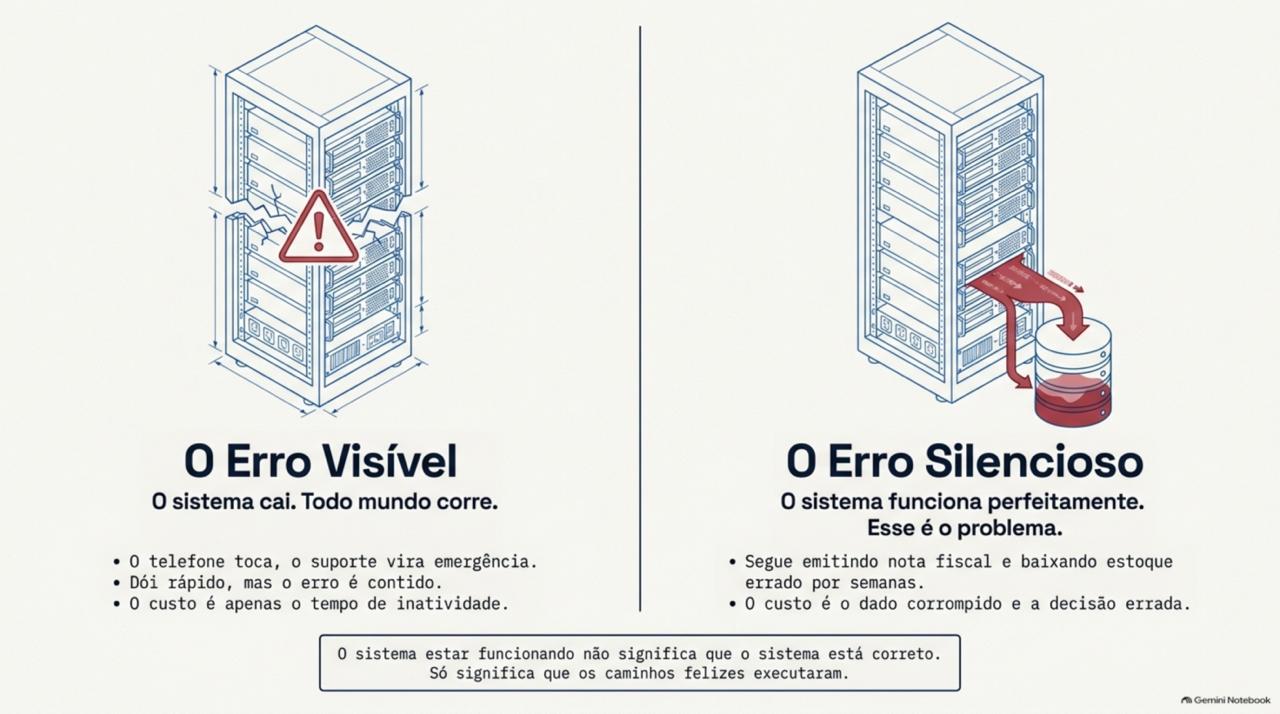
Quando um sistema cai, todo mundo percebe. O telefone toca, o suporte vira emergência, alguém cancela almoço pra restaurar backup. Dói, mas dói rápido — e o erro é contido.
O erro silencioso é outra categoria. O sistema continua funcionando. A tela abre, o usuário trabalha, a nota fiscal é emitida, o pedido é processado. Tudo parece normal. Só que um cálculo está vindo errado. Ou o estoque está diminuindo em quantidades erradas. Ou uma duplicidade silenciosa se acumula no banco. Ou uma regra fiscal que deveria valer só em determinada situação está sendo aplicada em todas — ou pior, em nenhuma.
Eu desenvolvo e mantenho ERP há décadas, e aprendi isso da forma mais difícil: o sistema estar funcionando não significa que o sistema está correto. “Funcionando” só diz que os caminhos felizes executaram. Não diz nada sobre o resultado.
Bugs de regra de negócio não estouram exceção
Erro de infraestrutura grita. Conexão recusada, timeout, null pointer — o log enche, o traceback aparece, alguém conserta.
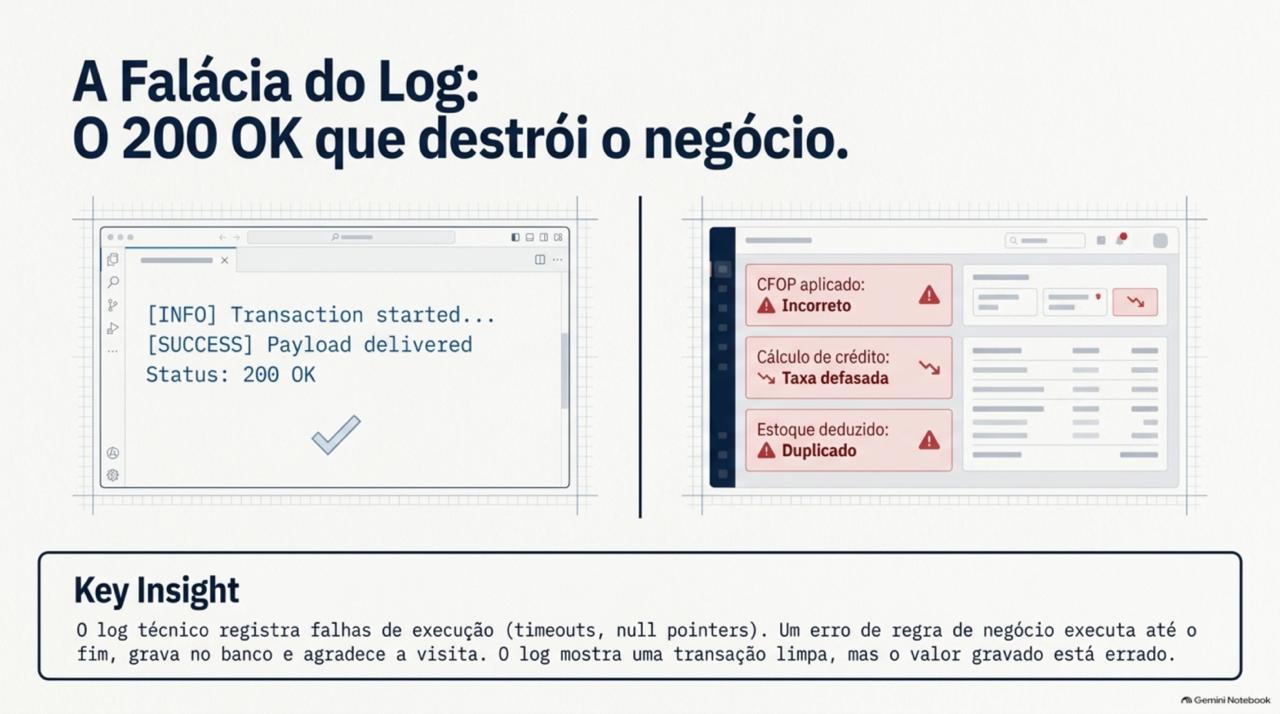
Erro de regra de negócio é mais educado. Ele executa até o fim, grava no banco e agradece a visita. Um CFOP aplicado na operação errada. Um cálculo de crédito que converte moeda com taxa defasada. Um desconto por volume que se aplica quando não deveria. Nenhum desses vira linha de log, porque para o sistema tudo aquilo foi sucesso.
E o pior: esse tipo de bug é frequentemente introduzido por mudanças legítimas. Alguém ajusta uma regra para atender um cliente novo e quebra a regra de outro — silenciosamente. Eu vivo exatamente isso no nosso ERP: são décadas de regras fiscais comerciais acumuladas, onde cada exceção nova convive com anos de comportamento antigo. Quem garante que a exceção nova não pisou no antigo? O testador humano do dia a dia — o cliente.
Semanas depois, ninguém lembra de nada
O erro silencioso tem segunda vítima: o tempo. O problema raramente é detectado no dia em que nasce. Aparece semanas depois, quando o contábil não fecha o mês, quando o estoque não bate com a contagem física, quando o cliente recebe a segunda via da nota e os valores não batem com o que ele tem gravado.
Nesse ponto, o custo explodiu. Não é mais um bug pra corrigir — são:
- Dados errados acumulados no banco, às vezes por semanas;
- Decisões tomadas com base nesses dados (compra, preço, tributo);
- A confiança do cliente, que agora faz dupla checagem de tudo que o sistema emite;
- E o trabalho sujo da investigação: qual dia começou? Qual release entrou a mudança? Quem mexeu na regra?
Corrigir o bug é a parte rápida. Corrigir as consequências é que carrega o custo real.
Log técnico não enxerga negócio
A resposta automática de todo desenvolvedor é “aí é só olhar o log”. Não é.
O log técnico registra o que a aplicação fez: chamadas, exceções, latências. Ele foi desenhado para capturar falhas de execução. Um cálculo errado não é uma falha de execução — é uma execução bem-sucedida de uma lógica errada. O log vai mostrar uma transação limpa, em tempo hábil, sem nenhum warning. E o valor gravado está errado.
Isso não quer dizer que log é inútil. Log técnico é essencial — para o que ele foi feito. O ponto é que ele é cego para a dimensão que mais custa: a correção do resultado de negócio.
Observabilidade de negócio: medir o que o sistema deveria produzir
Observabilidade de negócio muda a pergunta. Em vez de “o sistema está rodando?”, a pergunta vira “o sistema está produzindo os resultados esperados?”
Isto na prática significa instrumentar o sistema com métricas que o dono do problema entende:
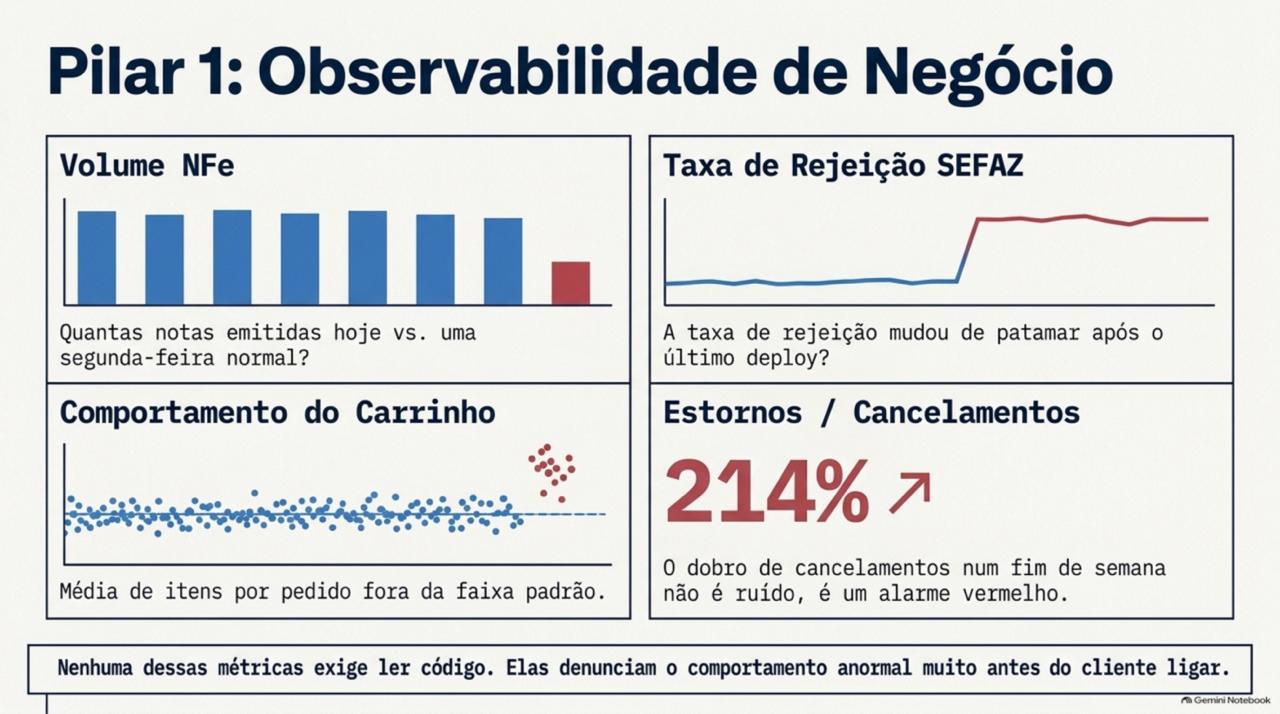
- Quantas notas fiscais foram emitidas hoje, e como esse número compara com uma segunda-feira normal;
- Qual a média de itens por pedido, e quantos pedidos fugiram para fora da faixa;
- Quantas devoluções, quantos estornos, quantos cancelamentos;
- Taxa de rejeição na SEFAZ, e se ela mudou de patamar depois de algum deploy.
Nenhuma dessas métricas exige ler código. Todas elas denunciam comportamento anormal muito antes de o cliente ligar. Quando o número de cancelamentos dobra num fim de semana comum, isso é o equivalente funcional de um alarme vermelho — o sistema caiu por dentro, mesmo com todos os processos no ar.
Auditoria de dados: conferir que o passado continua correto
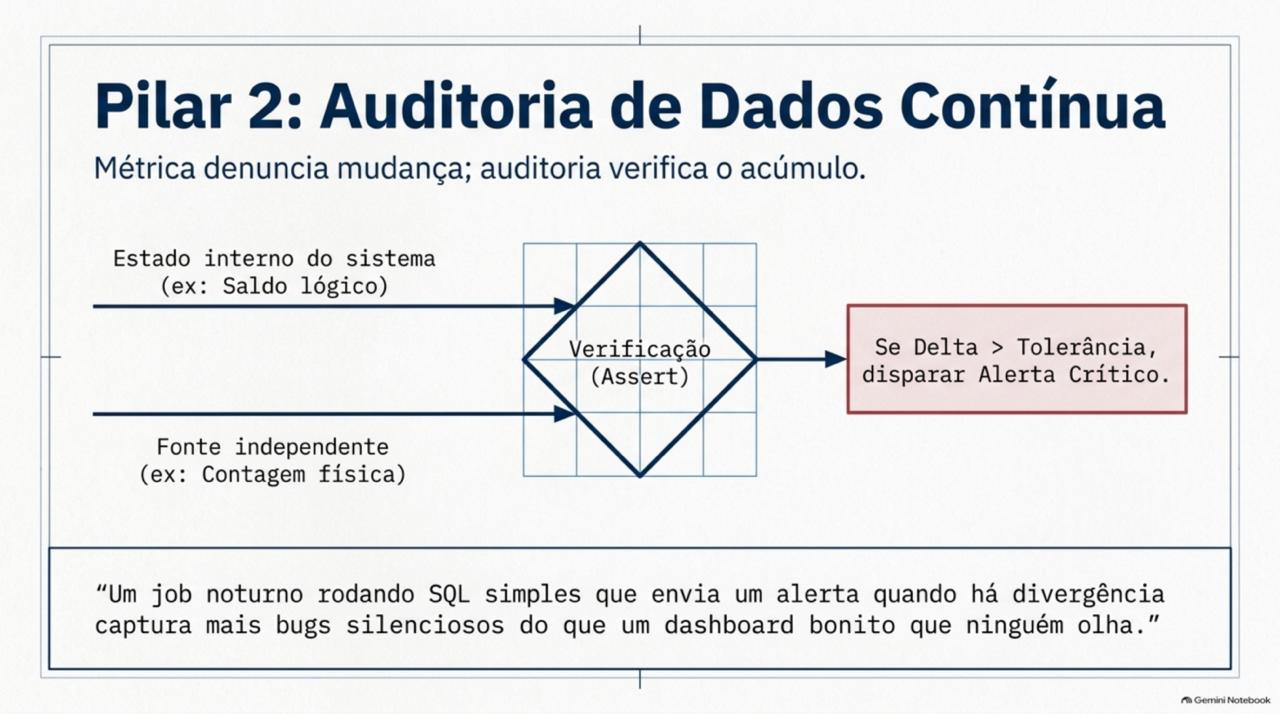
Métrica denuncia mudança de comportamento. Auditoria de dados verifica o acúmulo.
A ideia é simples: agendar verificações que comparam o estado interno do sistema com fontes independentes. Estoque do sistema versus contagem física amostral. Total contábil versus soma das notas emitidas. Saldo de duplicatas receber versus carteira emitida. Toda semana, um conjunto de asserts roda sobre os dados: se diferença supera tolerância, alguém é avisado — antes do fechamento mensal transformar a diferença em crise.
Não precisa de plataforma sofisticada pra começar. Um job noturno que roda SQL de comparação e envia e-mail quando diverge já pega a maior parte dos bugs silenciosos que levam semanas pra aparecer. Eu vi sistema ganhar muito mais com três queries de auditoria do que com um dashboard bonito que ninguém olha.
Detectar antes do cliente: testes de produção, não só de unidade
A fronteira final é reduzir o intervalo entre o erro acontecer e o erro ser percebido. Hoje, em muitos sistemas, esse intervalo é medido em semanas e a unidade de medida é o cliente.
Para encurtar, o que funciona na prática:
1. Verificações de sanidade pós-deploy: subir um release e rodar, em seguida, um conjunto de transações de verificação em ambiente de produção — emissão de nota de teste em série fiscal de homologação, pedido sintético, fechamento parcial do dia. Saída esperada, saída real, comparação automática. 2. Asserts de negócio embutidos no fluxo: dentro do código, nos pontos de maior risco, validações que o próprio sistema executa — se o valor calculado diverge do valor esperado além de tolerância, log com nível crítico e registro em tabela de anomalias, não exceção. 3. Comparação de indicadores antes/depois de cada release: o deploy terminou às 14h. O total de pedidos entre 14h e 17h se comporta como na mesma janela de ontem? Se não, o release é o primeiro suspeito — e o interrogatório acontece no mesmo dia, não três semanas depois.
O que eu levo daqui
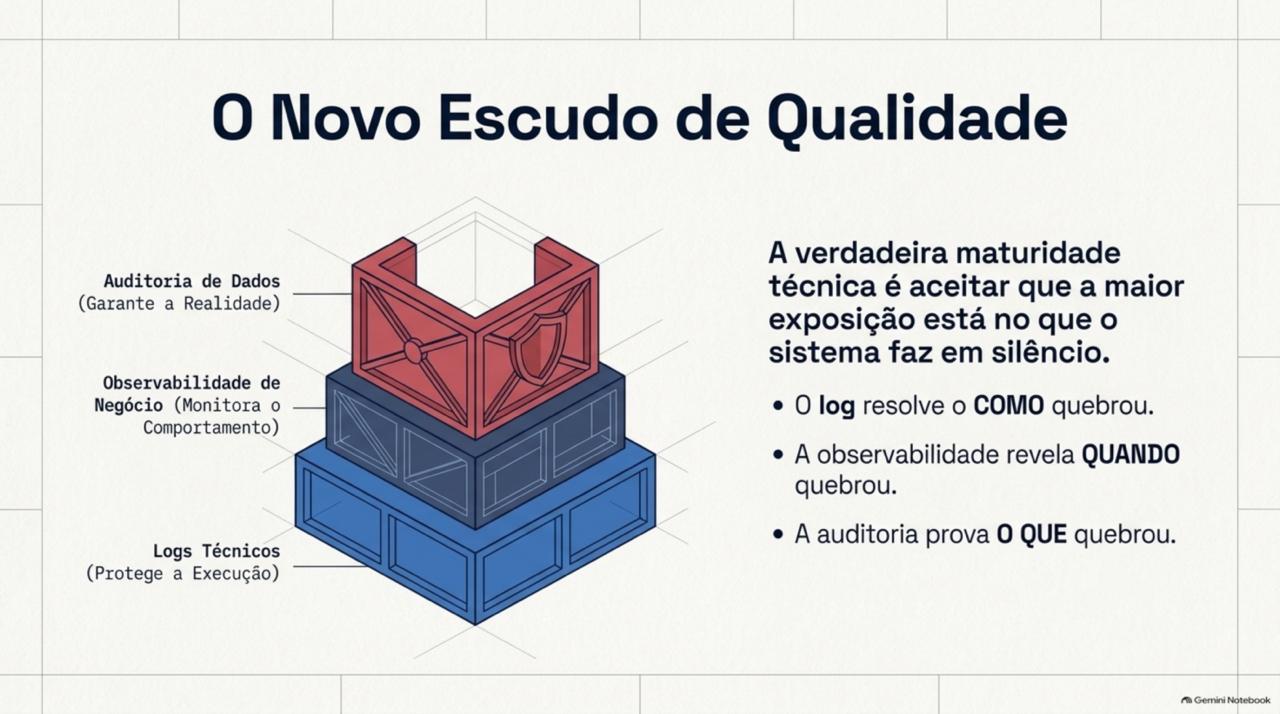
Erro derrubando sistema todo gestor de TI sabe priorizar. A mudança de mentalidade é aceitar que a maior exposição do sistema não está no que ele faz com barulho — está no que ele faz em silêncio. O log técnico protege a execução. Só a observabilidade de negócio e a auditoria de dados protegem o resultado.
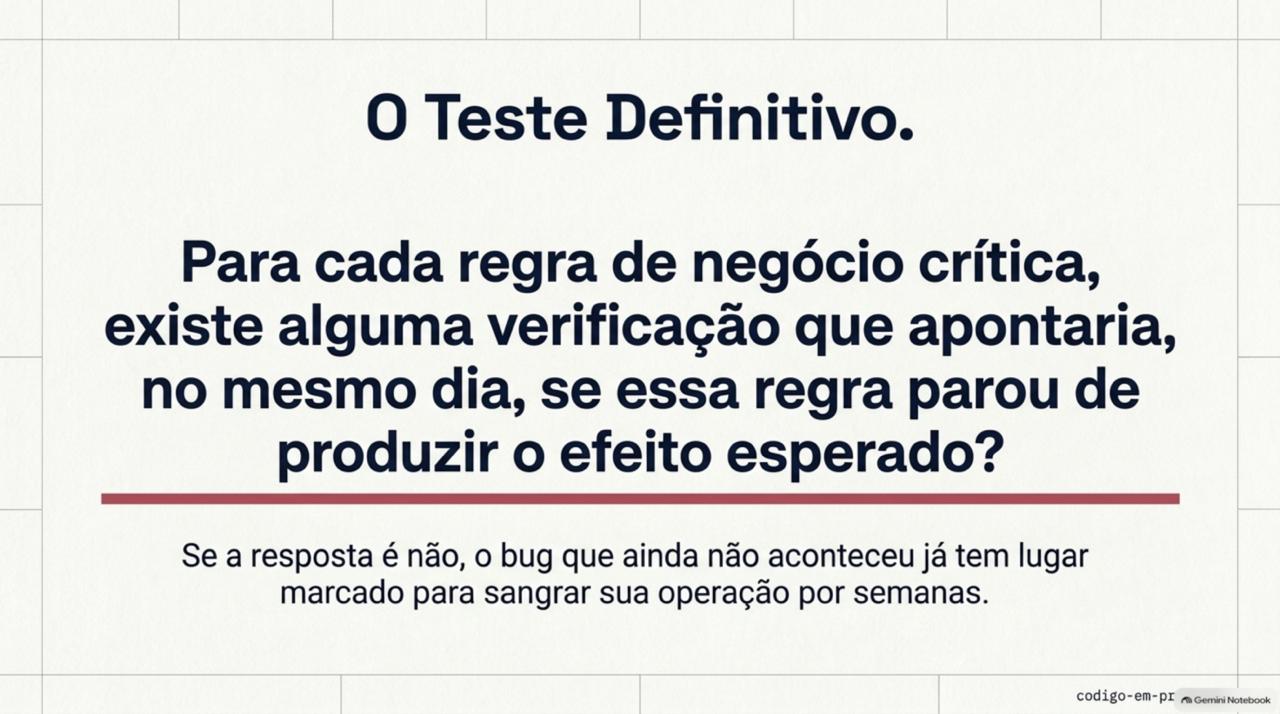
Minha régua hoje é: para cada regra de negócio crítica, existe alguma verificação — automática ou de rotina — que apontaria, no mesmo dia, se essa regra parou de produzir o efeito esperado? Se a resposta é não, o bug que ainda não aconteceu já tem lugar marcado pra ficar semanas sem ser percebido. E esse será, de novo, o bug mais caro da operação.
—
Leitura relacionada
- O código novo que ninguém consegue manter é pior que o legado — a qualidade que não se enxerga no “está funcionando” é a mesma que decide o custo do sistema no ano que vem.
- Migrar de Web Forms para .NET 10: dificuldades, riscos e benefícios — uma migração sem verificação automatizada de regras de negócio é um convite a bugs silenciosos em escala.
- Sistema legado não é sinônimo de sistema inútil — anos de produção validam caminhos felizes; os cantos escuros continuam lá.

2 Comentários